SuSy(Submission and Process Handling System)是MDPI的核心稿件处理系统,服务全球数万名编辑,日均处理稿件 2000 篇以上。
AI 推荐审稿人 · 技术预检 · 业务流程 · 前后端分离 · HTML 邮件
SuSy 同时支持500+期刊,服务全球数百万名作者和编辑,每天要处理 2000 多篇投稿。系统里的很多小问题,放到这个量级都会被放大。
不同学科、期刊的审稿标准和编委结构都不一样,同一套流程很难完全通用。
作者、编辑、审稿人、编委都在同一篇稿件上操作。任何一环卡住,审稿周期就会变长。
每天2000多篇投稿。人工环节多花一分钟,一天加起来就是两千多分钟。
过去要从审稿人库里找出方向匹配且available的审稿人,依靠手动搜索。
每篇新投稿,要先过几十项技术检查。规则不全篇、触发节点混乱,没有统一的流程。
这两件事占据了编辑每天80%以上的时间和精力
以前编辑靠关键词和主页找人,现在系统先按语义相似度排一遍,再把判断依据摆到编辑面前。
每天 2000 多篇投稿,每篇都要找多位审稿人。编辑大量时间花在搜索和筛选上。
原系统按研究方向关键词召回。关键词对得上,不代表研究内容真的接近。跨学科或者方法不同的稿件,经常被漏掉,或者推来的人不对口。
规则能召回的人有限。编辑还是得自己搜,逐个点开主页看,推荐没有省掉多少事。
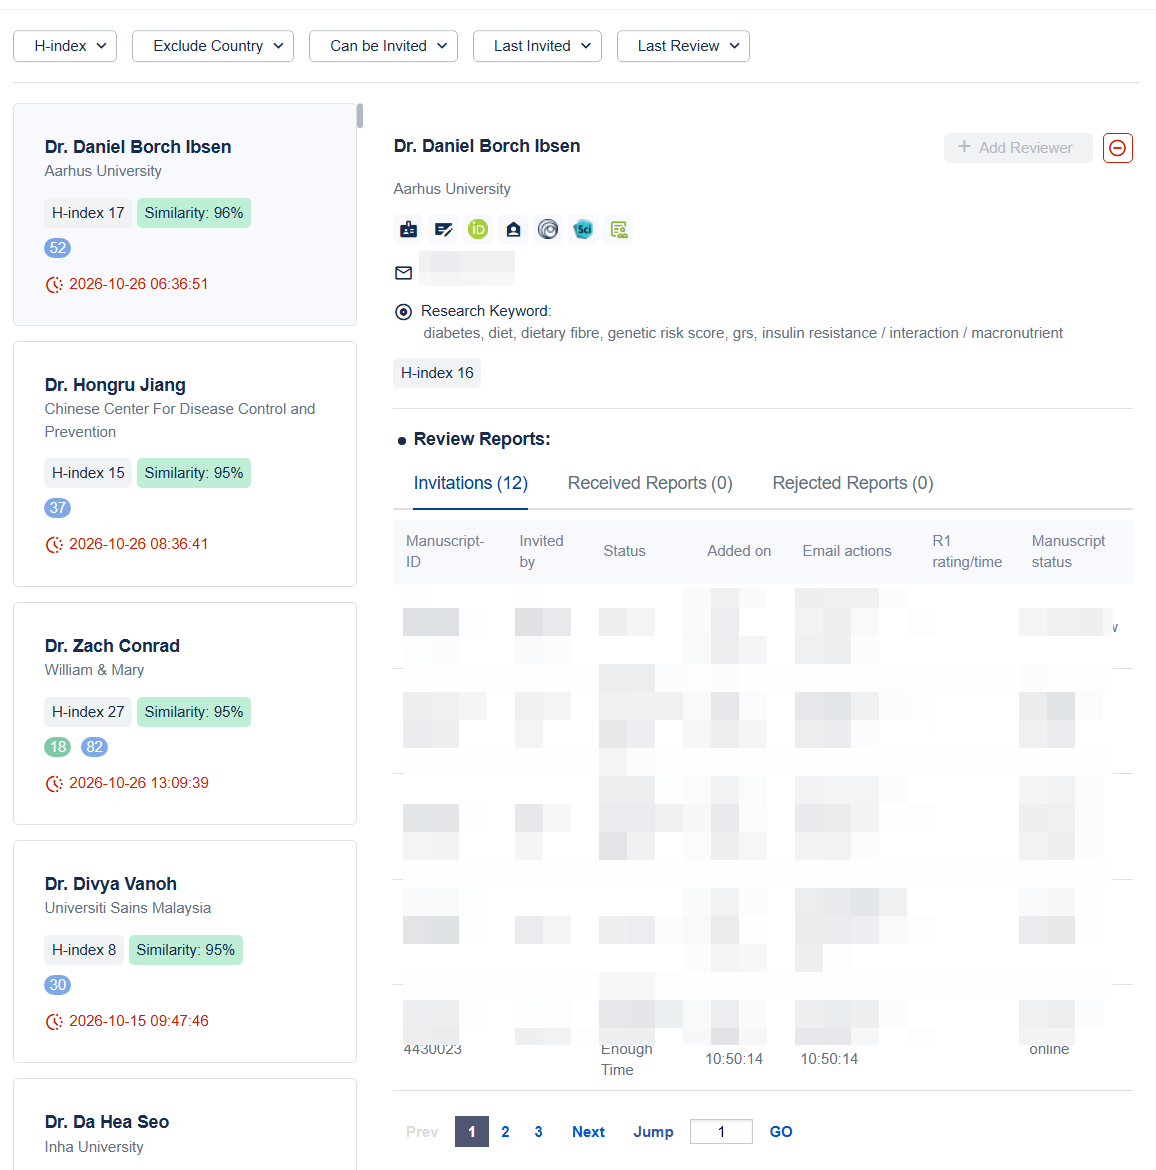
先把稿件的 title 和 abstract 向量化,和文章库比语义相似度,取最相关的前 X 篇。文章的作者进入候选池。
再按规则剔除有利益冲突、机构或合作关联、伦理争议,以及当前不可用的候选人。
剩下的人里,再算他们历史文章和当前稿件的余弦相似度,进行rerank。
编辑看到的是排序后的列表,加上每个人的信息卡片。确认或邀请由编辑点,系统不会自动发。
卡片里有研究方向关键词、过往投稿和审稿记录、h-index、编委过往决定,还有个人主页。
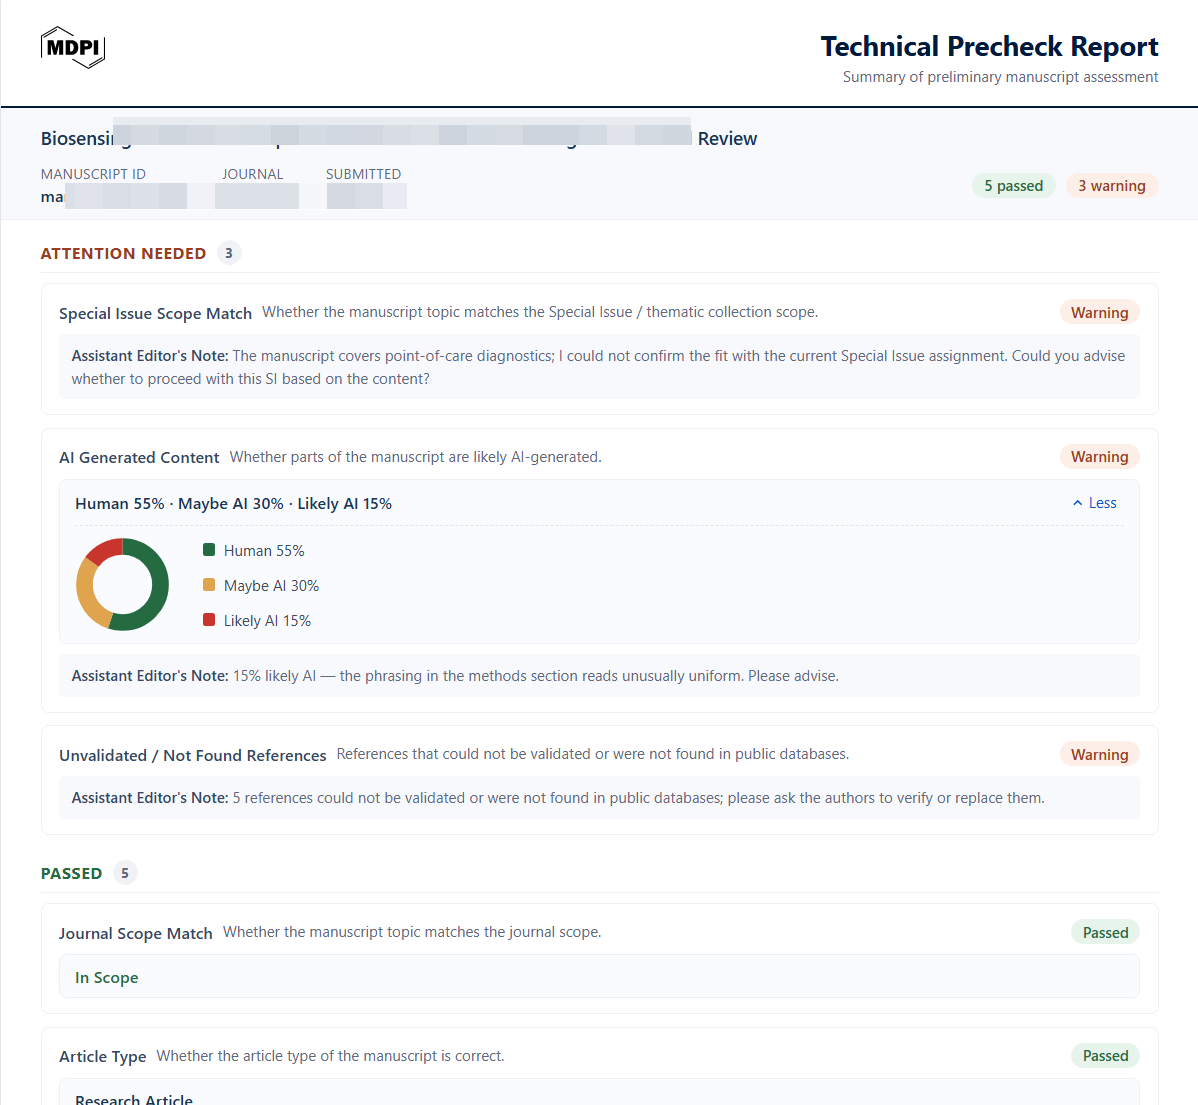
在特定节点触发技术预检,根据业务需要和资源设定同步检查和异步检查,生成技术预检报告
每天 2000 多篇稿子,每篇几十项技术检查。很多检查靠人一项项看,标准/稳定性都不可保障
格式、完整性可以写规则。期刊匹配度、英语水平、疑似 AI 生成这些,规则判不了,只能人工看
检查结果散在不同地方,编辑很难一眼看完。漏看一项,就容易引起学术诚信问题
作者提交成功后,系统在后台建一个解析+预检任务,无需在线等待。每当revision时自动触发,保证实时性
多项标准检查和三项 AI 检测(期刊匹配度、英语水平、疑似 AI 生成)分开跑。一项失败,不影响其他项出结果。
每类任务有自己的错误处理规则,界面清晰,保留手动重试入口,不静默跳过,也不影响其他检测项目。
汇总成一张静态的技术预检报告,由内部编辑决定报告的最终形态,可留言,可修改,用于编委决定送审、退回还是人工复核。
接到一个 AI 需求,我第一个问题通常不是它能不能做,而是这件事原来是怎么做的。谁在做、做一次要多久、弄错了谁收拾。这几句说不清楚,需求本身就没成立,只是把“我们也该用 AI”换了个说法。
这两年见过不少“我们也要接大模型”的提案,往下追问三层就卡住。技术上都做得出来,可做出来解决的往往不是真问题,最后只是多一个没人点开的入口,和一份要一直维护的调用成本。
判断标准其实很朴素:这件事是不是已经到了人做不完,或者不同的人做出来结果不一样的程度。如果现在的做法还凑合,省下来的那点时间,通常撑不起一个 AI 项目的成本和风险。
AI 产品经理这两年热门,是因为大模型刚落地那阵,懂一点模型能力和完全不懂的人,做出来的东西差得很远。等这些能力沉到基础设施那一层,差距会收窄。今天没人把“懂数据库”写进产品经理的岗位名称,AI 大概率也会走到这一步。
我自己的理解是:以后的 AI 产品经理,是做 AI 产品的产品经理,不是精通 AI 能力的产品经理。前者要想的是这个产品该不该有这个能力、给了之后谁来兜底;后者想的是这个能力怎么实现。后者是加分项,前者是本职。
所以我不觉得这是个能干十年的头衔,但它是个很好的观察位置。